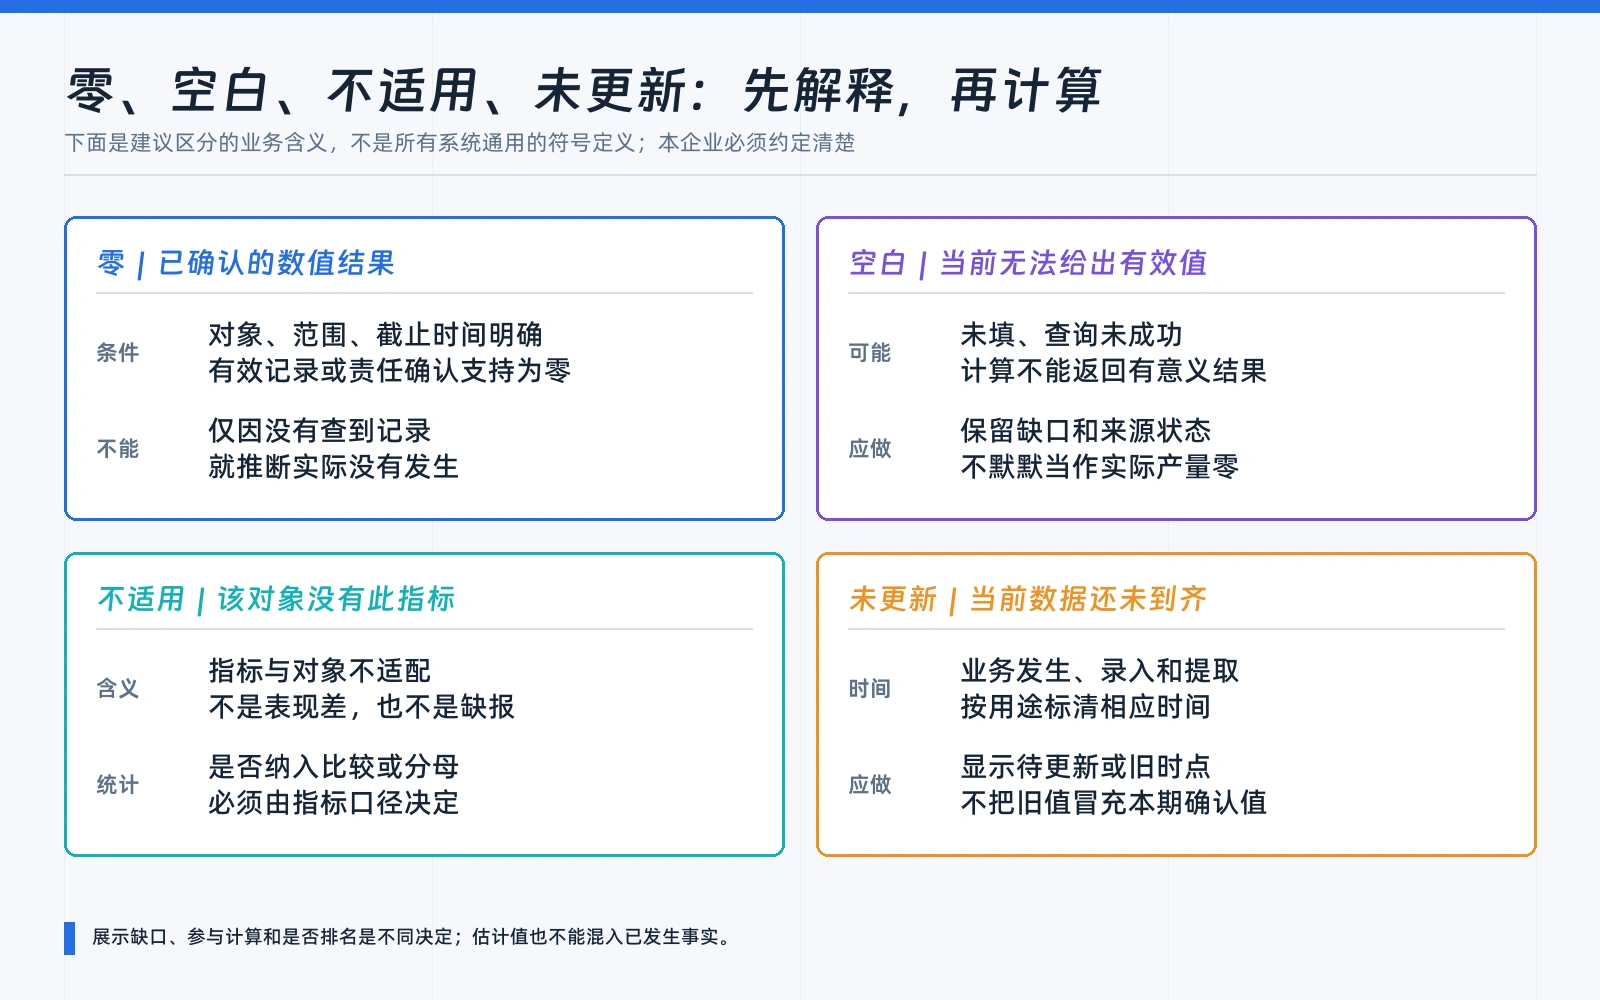
同样一个0,可能是当班确实没有产出,也可能只是给空格补了值。前者有确认依据;后者还得回查班组报数与取数过程,不能直接算成零产出。
读生产报表时,数值和来源状态要一起看。某条产线已经核实本班没有产出,可以记0;查询没有返回记录,则还要分清是确实没有发生、尚未填报,还是取数不完整。这里讨论的是数值能说明什么,报工、完工、入库各自代表的事件,可另看生产业务状态的区别。
同样是一个零,后续要查的事情可能不同
经核实的零可以进入约定的统计;来源不明的空白,先查字段说明和取数过程。如果只是查询漏了一个车间,应修正查询范围;如果班组还没提交,就应把这个对象留在缺报清单里。若表里只留下补好的零,这两类缺口就看不出来,后续看到低产量的人可能转而去查生产原因。
“不适用”也需要单独放。如果某工序没有这项指标,它不属于该指标的评价对象,不能被当成一次零表现。它是否出现在汇总页、是否计入某个比率,仍按该指标的定义决定。企业可以采用不同符号,但要让使用报表的人查得到含义。
平均数算对了,回答的却可能不是原来的问题
假设按同一口径统计三条产线本班产量:甲已确认60件,乙已确认0件,丙尚未提交。只计算两条已确认产线,均值为30件;把丙的空白也当0,均值就成了20件。
20件把尚未提交当成了零产出,30件也不能直接写成“三条产线的平均产量”。它只描述目前两条有效记录。丙的数据补齐前,三条产线的最终均值还没有依据;报表可以先展示已确认均值,同时注明有效记录2条、待提交1条,让读者知道少了什么。
所以,保留所有产线在页面上,和让所有产线参加计算,是两个决定。为了追缺报,丙需要显示;这不要求给丙编一个产量。不适用项若混进应完成对象的分母,也会改变完成率,具体分母仍须回到指标口径。
微软对Power BI空白值的建模建议就区分了返回数值与显示分组:把空白转成0,可能让原来没有值的分组也出现在报表中;需要展示无数据对象时,还可以另行配置显示方式。这是该工具的具体行为,不能直接套成所有生产指标的补值规则。
丙的格子里出现60件,能不能算进去
继续用前面的假设。稍后刷新报表,丙的格子里出现了60件。如果这是本班新提交且已确认的产量,三条产线的均值可以重算为40件。可如果这60件沿用上一班,当前班次仍然缺报,能确认的就还是甲、乙两条。格子不空了,不代表数据已经补齐。
要分清这两种情况,得往回找原记录:产量属于哪一班,记录何时录入,报表又是什么时候取到它的。班组已经提交当班记录,页面却还停在旧值,就查提取或刷新;源头尚未填报,反复刷新也等不来当前班次的产量。一个笼统的“更新时间”,交代不清这些差别。
等丙本班的60件确实补齐,40件才有了依据。首次发布时那份“两条有效记录,均值30件,丙待提交”的结果也要留得住。否则,回头看报表的人只见到40件,会以为最初就掌握了三条产线的数据。将缺报版、补齐版与修正来源对应保存,何时重发或更正,按企业的报表流程办。跨班次、跨产线比较时,统计对象、单位、截止时间和缺失处理也得对齐;存在差别,就在比较处说明。
先让灵核整理缺报,还是直接分析产量
灵核数智是面向制造业的岗位级AI数智员工平台。用在这份报表上,可以先评估缺报整理这项工作。丙尚未提交,报告里就还有一项待办:找到需要追查的产线、现有记录和取数时点,交给报表负责人继续核实。资料不足以区分未提交与提取遗漏,就把原因留作待核,不能凭空选一个。
灵核的作业指导书用于写明完整业务的步骤与约束。在这项任务里,要约定从哪些获准读取的材料查起,查不到时怎样交付,谁来核对。读取工具与系统接入另行验证,权限沿用调用人的既有范围。业务若需要估计,估计值及依据单列,不能混入已确认的产量。
带着缺报版、补齐版两份脱敏报表,以及源记录和字段说明,就可以与灵核讨论任务范围。按真实任务测试的方法,把零、不适用和上一班旧值留在样本里,核对输出是否保留了这些区别,再看补报前后的缺口有没有如实交代。